
Contenido
- Empieza con una imagen que el modelo no tenga que reparar
- Escribe un prompt de movimiento, no una segunda descripción de la imagen
- Utiliza el primer clip como renderizado de validación
- Decide si debes perfeccionar, volver a intentarlo o sustituir
- Convierte los clips aceptables en un flujo de trabajo repetible Actualizado el 12 de octubre de 2026
Un vídeo para adultos convincente generado con IA suele comenzar antes de pulsar el botón Generar. La imagen de origen debe proporcionar al modelo un sujeto estable, el prompt debe describir un movimiento realizable y el primer renderizado debe tratarse como una pasada de diagnóstico, no como un clip terminado.
Playbox AI es un generador de vídeo con IA para adultos 18+. Este artículo explica cómo preparar la entrada, planificar el movimiento y la cámara, revisar las opciones actuales del producto y evaluar el resultado antes de un nuevo intento específico.
Playbox AI es un generador de vídeo con IA para adultos 18+. Este artículo explica cómo preparar la entrada, planificar el movimiento y la cámara, revisar las opciones actuales del producto y evaluar el resultado antes de un nuevo intento específico.
Empieza con una imagen que el modelo no tenga que reparar
Una imagen de origen no es una mera inspiración. En la generación de imagen a vídeo, establece la composición inicial, el sujeto, la iluminación, el fondo y el estilo visual. A continuación, el prompt de movimiento indica al modelo qué debe cambiar con el paso del tiempo.
El flujo de trabajo de Playbox AI comienza con un único sujeto adulto renderizado con nitidez y bajo una iluminación uniforme. Su guía para principiantes recomienda recortar la imagen lo suficiente para que el rostro ocupe aproximadamente un tercio del encuadre. Se trata de un objetivo práctico, no de una especificación universal: un rostro reconocible proporciona al modelo más detalles aprovechables que un sujeto de cuerpo entero situado a distancia, especialmente cuando el resultado es corto o de baja resolución.
Examina la imagen a tamaño completo antes de subirla a cualquier sitio. Busca:
- Rasgos faciales borrosos o asimétricos
- Dedos ocultos unos detrás de otros o que ya estén deformados
- Cabello que se confunda con el fondo
- Patrones repetidos, espejos, barandillas o texturas densas detrás del sujeto
- Sombras intensas que atraviesen el rostro o el cuerpo
- Desenfoque o polvo que sugiera movimiento en la dirección equivocada
Es probable que los defectos existentes se vuelvan más visibles una vez sintetizados los fotogramas. La guía oficial de Runway sobre prompts de imagen a vídeo advierte específicamente que las manos o los rostros borrosos de una imagen de entrada pueden acentuarse durante la animación.
Las manos merecen una decisión deliberada. Si son pequeñas, se superponen, quedan parcialmente fuera del encuadre o son fundamentales para una acción complicada, utiliza un recorte diferente o elige una imagen en la que reposen contra el cuerpo o sobre un objeto sencillo. Pedir al modelo que invente al mismo tiempo una anatomía detallada y un movimiento rápido crea dos puntos de fallo a la vez.
El fondo también debe favorecer el movimiento previsto. Una pared lisa, un gradiente tonal amplio o una habitación suavemente desenfocada son más fáciles de mantener estables que el follaje, una tela estampada, una multitud o superficies reflectantes. Cuando el fondo sea importante para la escena, consérvalo, pero reduce los movimientos innecesarios del sujeto y de la cámara durante el primer intento.
Escribe un prompt de movimiento, no una segunda descripción de la imagen
Una vez que la imagen proporciona la apariencia, el prompt debe concentrarse en el tiempo: qué hace el sujeto, con qué rapidez sucede, qué hace la cámara y cómo termina la toma.
Una estructura útil es:
Acción del sujeto + ritmo + comportamiento de la cámara + condición de continuidad
Por ejemplo:
El sujeto gira lentamente hacia la cámara y esboza una sonrisa sutil. El cabello se mueve suavemente. La cámara avanza muy despacio. Toma continua con iluminación estable.
Este prompt separa el movimiento contenido del sujeto del movimiento de la cámara. También evita volver a describir la ropa, la habitación, la forma del cuerpo u otra información visual que ya esté presente en la imagen. Repetir esos detalles puede introducir contradicciones sin mejorar el movimiento.
Empieza con una sola acción esencial. Las indicaciones oficiales de Adobe, actualizadas el 9 de junio de 2026, recomiendan identificar el tipo de toma, la acción del personaje, la ubicación y la estética mientras se perfeccionan los prompts de forma gradual; sus indicaciones para prompts de vídeo también abarcan el ritmo y la dirección de la cámara. Sin embargo, en trabajos de imagen a vídeo, añade descriptores visuales únicamente cuando el modelo necesite realmente información que no esté presente en el fotograma de origen.
Evita combinar varias instrucciones exigentes en la primera pasada. Un prompt que solicite un giro, un gesto con la mano, cabello ondeando, un cambio importante de expresión, una cámara giratoria y una transición del fondo dificulta el diagnóstico. Si el resultado falla, no habrá una forma clara de identificar qué instrucción lo causó.
Las pistas de la imagen y las indicaciones escritas deben concordar. Runway documenta un caso útil en el que un prompt pedía que un coche aparcado permaneciera inmóvil, pero la imagen de origen contenía nubes de polvo y desenfoque de movimiento. Eliminar esas pistas contradictorias produjo el comportamiento deseado con el mismo prompt. La lección se aplica de forma general: cuando el vídeo ignore una instrucción, examina la imagen de origen antes de añadir más palabras.
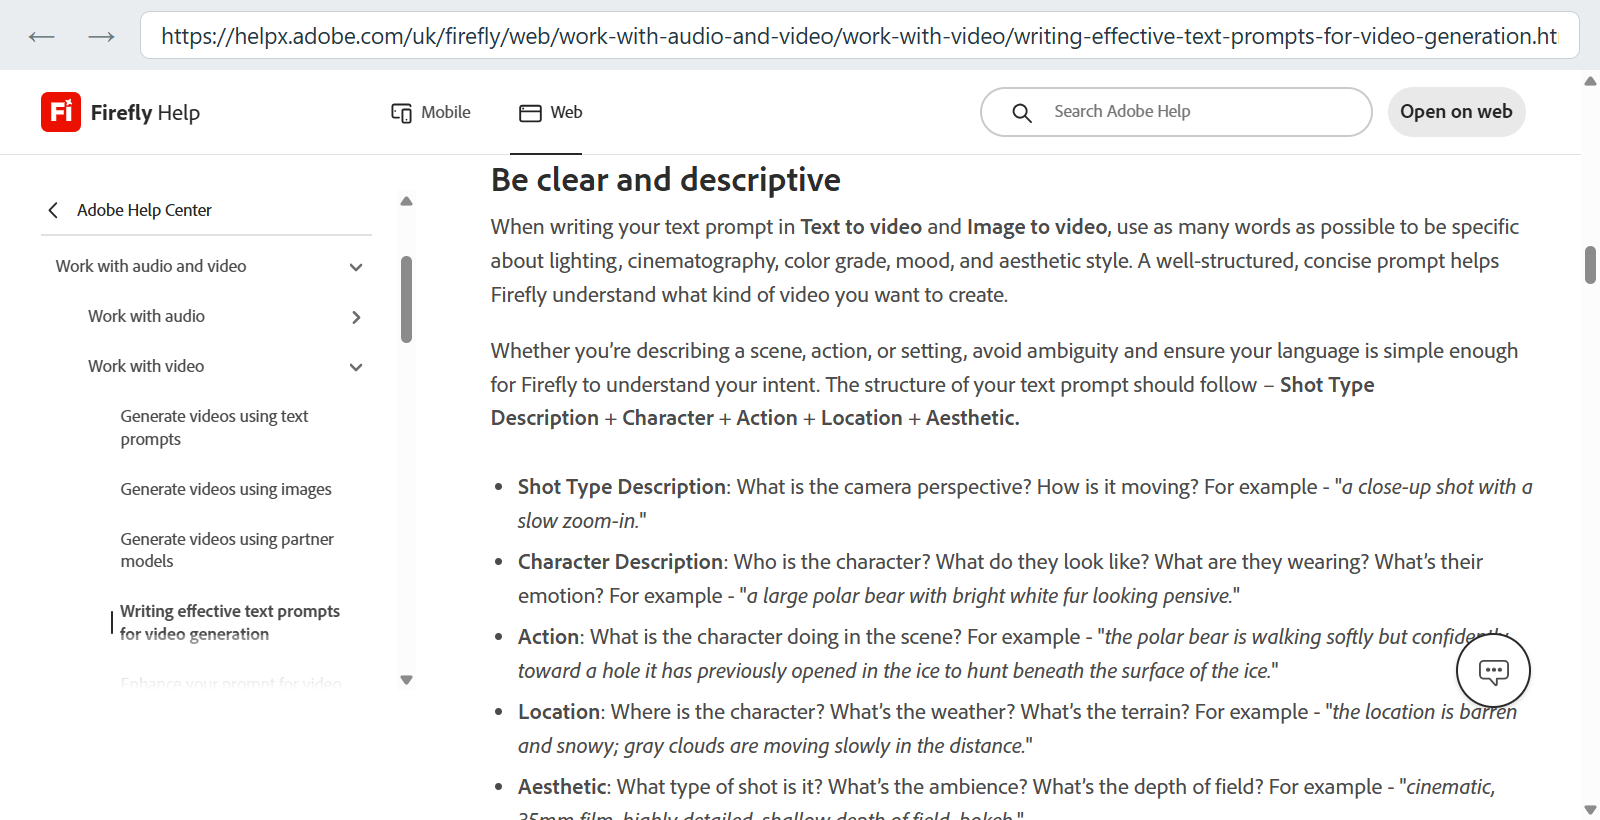
El marco general de Adobe para prompts de vídeo ofrece una lista de comprobación útil; en los prompts de imagen a vídeo, da prioridad al movimiento y a la dirección de la cámara cuando el fotograma de origen ya proporcione los detalles visuales.
Utiliza el primer clip como renderizado de validación
Elige el renderizado disponible más corto o menos costoso para el primer intento cuando el generador externo ofrezca esa posibilidad. Selecciona un movimiento contenido, como una pose inmóvil, un ligero cambio de expresión o un lento avance de la cámara, antes de probar una secuencia más ambiciosa.
Este primer clip responde a una pregunta concreta: ¿interpreta el sistema correctamente la imagen de origen?
Míralo varias veces, centrándote en un aspecto diferente en cada pasada:
- Impresión general: ¿Comunica el clip la acción prevista sin un corte brusco ni una transformación inexplicable?
- Identidad y anatomía: ¿Sigue siendo reconocible el rostro? ¿Mantienen la coherencia las manos, las extremidades y las proporciones corporales?
- Entorno: ¿Permanece fijo el fondo donde debería hacerlo o los detalles finos hierven y se desplazan?
- Movimiento: ¿Son fluidos los movimientos o los fotogramas se emborronan, saltan o invierten brevemente la dirección?
- Luz y color: ¿Se mantienen uniformes los tonos de piel, los colores de la ropa y la iluminación desde el principio hasta el final?
Esta revisión es más fiable que basarse en si el clip resulta impresionante a primera vista. La investigación sobre VBench de 2024 evaluó el vídeo generado en 16 dimensiones distintas, entre ellas la consistencia del sujeto, la consistencia del fondo, el parpadeo temporal, la fluidez del movimiento, la calidad de imagen, la acción humana y la coherencia con el prompt. Una revisión personal no reproduce ese benchmark, pero las categorías ofrecen un recordatorio útil de que un clip puede funcionar en una dimensión y fallar en otra.
Por ejemplo, un rostro puede permanecer estable mientras la pared situada detrás palpita. Un clip visualmente fluido puede ignorar la acción solicitada. Una acción correcta puede seguir siendo inutilizable porque el color cambia a mitad del vídeo. Registra estas cuestiones como observaciones independientes en lugar de asignar a todo el resultado una valoración imprecisa de aprobado o suspenso.
Decide si debes perfeccionar, volver a intentarlo o sustituir
La ubicación del defecto determina el siguiente paso.
| Lo que observas | Causa probable | Mejor acción siguiente |
|---|---|---|
| El sujeto es correcto, pero el movimiento es demasiado intenso | El prompt o el ajuste preestablecido de movimiento exige demasiado | Reducir la velocidad, la distancia o el número de acciones |
| El rostro se desvía durante un giro | El rostro es demasiado pequeño, la luz cambia o la rotación es excesiva | Recortar más y solicitar un giro menor |
| Las manos se fusionan o se multiplican | Anatomía de origen poco clara combinada con movimiento de las manos | Reencuadrar para excluir las manos o utilizar una pose de reposo |
| El fondo parpadea | Demasiados detalles finos o desplazamiento excesivo de la cámara | Simplificar el fondo o mantener la cámara más estable |
| El movimiento contradice el prompt | La imagen de origen contiene pistas direccionales opuestas | Editar o sustituir la imagen antes de reescribir el prompt |
| El resultado es coherente, pero omite una instrucción | El prompt es ambiguo o demasiado amplio | Perfeccionar la redacción manteniendo la imagen de origen sin cambios |
| Aparecen varios defectos no relacionados | La combinación entre la imagen de origen y el movimiento es inestable | Sustituir la imagen de origen o elegir un movimiento de menor magnitud |
Perfecciona cuando la imagen de origen se mantenga estable y el problema esté localizado. Si el sujeto se mueve demasiado rápido, cambia «gira hacia la cámara» por «gira lentamente la cabeza unos pocos grados hacia la cámara». Si el movimiento de la cámara eclipsa la acción del sujeto, elimina la instrucción de la cámara durante una pasada.
Vuelve a intentarlo sin cambios únicamente cuando se sepa que el servicio produce variaciones significativas y el primer resultado se acerque lo suficiente como para conservarlo. Repetir una generación con un rostro borroso, manos ambiguas o pistas de movimiento contradictorias solo pide al modelo que resuelva de nuevo el mismo problema de entrada.
Sustituye o vuelve a recortar la imagen de origen cuando los defectos aparezcan en el primer fotograma, la identidad se desvíe repetidamente o el fondo se desestabilice con distintos prompts. Dos fallos de la misma combinación de imagen de origen y movimiento suelen aportar más información que una larga sucesión de regeneraciones esperanzadas.
Convierte los clips aceptables en un flujo de trabajo repetible
Cuando una combinación funcione, conserva las condiciones que la produjeron. Mantén dos o tres configuraciones de origen fiables con una distancia, iluminación y fondo similares. Cambia una sola variable cada vez para que el siguiente resultado siga siendo interpretable.
Utiliza nombres de archivo que reflejen la imagen de origen, el movimiento elegido, el número de intento y el veredicto, como:
portrait-windowlight_slow-turn_a03_keep.mp4
Un registro sencillo puede añadir el prompt, la duración, el defecto observado, la corrección y la decisión final. A lo largo de varias sesiones, esto revela si un recorte concreto protege sistemáticamente la identidad facial o si una instrucción de cámara desestabiliza repetidamente el fondo.
El objetivo no es eliminar todas las variaciones. Consiste en distinguir las variaciones productivas de los fallos evitables. Conserva entradas estables, simplifica el movimiento antes de intensificarlo y dedica renderizados adicionales únicamente después de que el clip de validación demuestre que el modelo comprende la imagen de origen.
Para consultar explicaciones más detalladas sobre los primeros renderizados, la corrección de artefactos y las configuraciones de origen repetibles, continúa con las guías verificadas de Playbox AI. Utilizado de este modo, Playbox AI funciona como un práctico acompañante editorial: prepara el fotograma, describe un movimiento realizable, examina el resultado por categorías y modifica la entrada que realmente causó el problema.